Avatar de agente de voz: mapeamento de eventos do OpenAI Realtime
Por equipe Charmotion · Atualizado em
Controle o avatar de um agente de voz com os eventos de servidor do OpenAI Realtime: input_audio_buffer.speech_started para listening, speech_stopped para thinking, o primeiro áudio de uma resposta para talking e o fim da reprodução para idle. Via WebRTC, output_audio_buffer.started e stopped marcam a reprodução; via WebSocket, acompanhe sua própria fila de reprodução.
Principais pontos
input_audio_buffer.speech_startedespeech_stoppedvêm do VAD do servidor e correspondem a listening e thinking.- O nome atual do evento de áudio é
response.output_audio.delta; tutoriais mais antigos usamresponse.audio.delta. output_audio_buffer.started,stoppedeclearedestão documentados como exclusivos de WebRTC/SIP.- Trate uma resposta cancelada após uma interrupção do usuário (barge-in) como algo normal e tenha um fallback para um evento
stoppedque chegue atrasado.
Já tem um personagem ou logo? Veja seu personagem em telas reais de app: telas de splash, onboarding, carregamento e estado vazio. É grátis, roda no navegador e não envia nada.
Quais eventos do Realtime indicam que o usuário começou ou parou de falar?
Com a detecção de atividade de voz (VAD) do servidor ativada, a Realtime API envia input_audio_buffer.speech_started quando detecta fala no buffer de áudio. A referência da OpenAI diz que o cliente pode usar esse evento para interromper a reprodução de áudio ou oferecer feedback visual, que é exatamente a função de um avatar. Depois, ela envia input_audio_buffer.speech_stopped quando a fala termina (eventos de servidor da OpenAI).
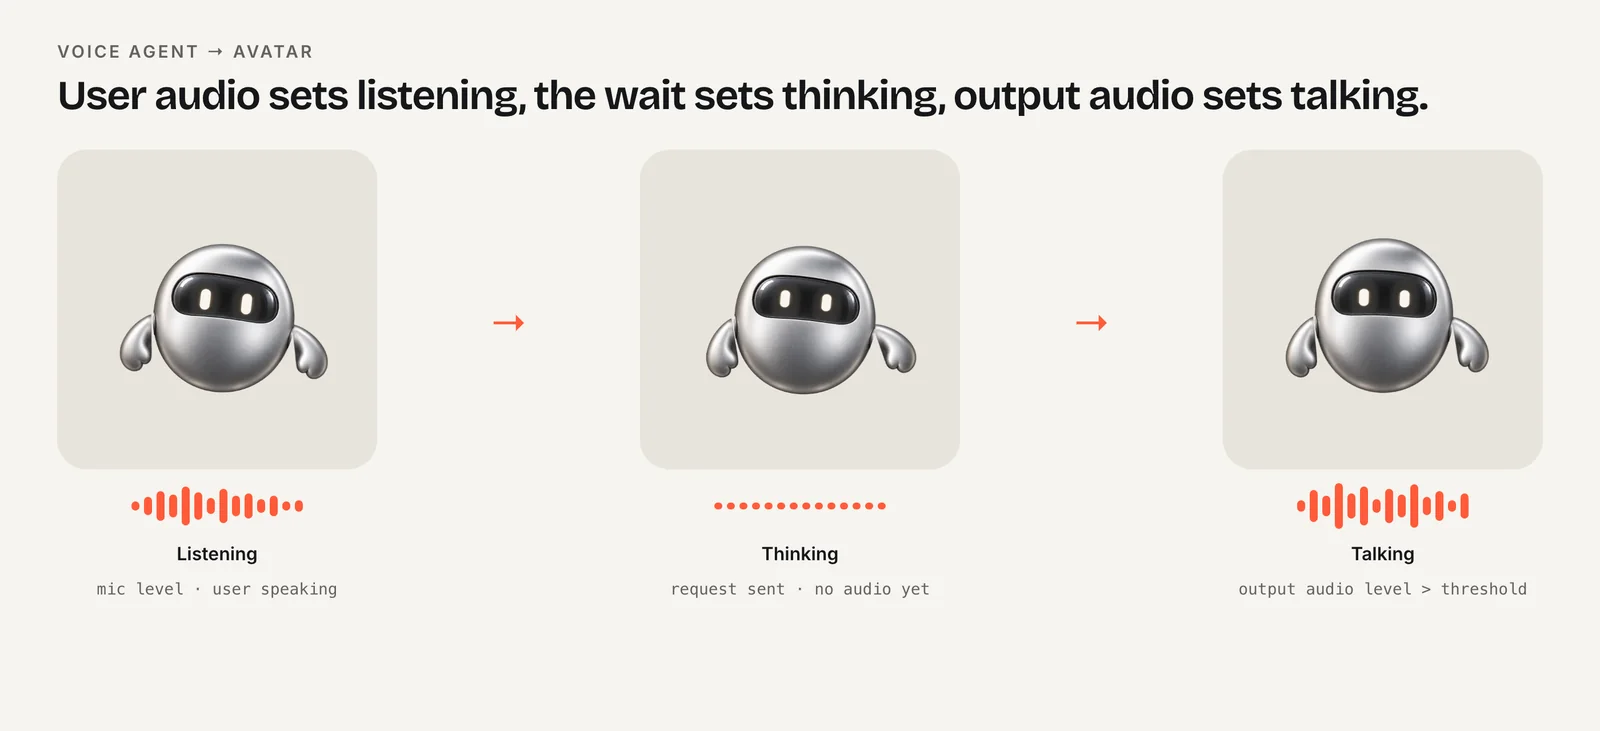
Mapeie assim:
speech_started→ listening. Mude na hora. Este é o momento do "estou ouvindo", e qualquer atraso dá a impressão de que o agente não está prestando atenção.speech_stopped→ thinking. O modelo está prestes a responder. Esse intervalo costuma ser curto, mas é perceptível.
Esses eventos dependem do VAD. Se você desativar o VAD e fizer o commit do buffer de áudio por conta própria (push-to-talk), já sabe quando o usuário começa e para de falar, porque são os seus próprios handlers de botão que fazem isso. Defina listening ao pressionar e thinking ao soltar.
Tópicos da comunidade relatam que speech_stopped pode chegar atrasado, ou simplesmente não chegar, em ambientes com ruído. Não deixe o avatar travado: se uma resposta começar enquanto você ainda estiver em listening, vá direto para talking.
Como saber quando o modelo começa e para de falar?
É aqui que o transporte faz diferença. A Realtime API pode rodar sobre WebRTC (áudio em uma media track, eventos em um data channel) ou sobre WebSocket (áudio e eventos como mensagens JSON).
| Fase | WebRTC | WebSocket | Avatar |
|---|---|---|---|
| O usuário começa a falar | input_audio_buffer.speech_started | Igual | Listening (6) |
| O usuário para de falar | input_audio_buffer.speech_stopped | Igual | Thinking (3) |
| O áudio do modelo começa | output_audio_buffer.started | Primeiro response.output_audio.delta | Talking (7) |
| O áudio do modelo termina | output_audio_buffer.stopped | Sua fila de reprodução se esvazia | Idle (0) ou listening (6) |
| O usuário interrompe | output_audio_buffer.cleared | speech_started + parar a reprodução | Listening (6) |
| Falha na resposta | response.done, status failed | Igual | Disparar error |
A OpenAI documenta que output_audio_buffer.started é emitido quando o servidor começa a transmitir áudio para o cliente, e que stopped é emitido quando o buffer de saída foi totalmente esvaziado no servidor, depois de response.done. Os dois são marcados como exclusivos de WebRTC/SIP. Via WebSocket, o áudio chega em blocos Base64 em response.output_audio.delta, seguidos de response.output_audio.done (eventos de servidor da OpenAI).
Observe que response.output_audio.done significa que o servidor terminou de enviar o áudio, não que o usuário terminou de ouvi-lo. Blocos ainda na fila do seu player podem continuar tocando por alguns segundos depois disso.
Como conectar os eventos a um avatar Rive via WebRTC?
Via WebRTC, os eventos do servidor chegam como strings JSON no data channel que você criou para eventos. Faça o parse de cada mensagem e use um switch em type. O avatar é atualizado pela API de Data Binding do runtime web do Rive: number("mood").value para os loops e trigger("error").trigger() para as reações únicas (Data Binding no Rive para web).
import type { ViewModelInstance } from "@rive-app/webgl2";

const MOOD = { idle: 0, thinking: 3, listening: 6, talking: 7 } as const;

export function bindAvatarToRealtime(dc: RTCDataChannel, vmi: ViewModelInstance) {
  const mood = vmi.number("mood");
  const setMood = (m: number) => {
    if (mood) mood.value = m;
  };

  dc.addEventListener("message", (e) => {
    const ev = JSON.parse(e.data);
    switch (ev.type) {
      case "input_audio_buffer.speech_started":
      case "output_audio_buffer.cleared":
        setMood(MOOD.listening);
        break;
      case "input_audio_buffer.speech_stopped":
        setMood(MOOD.thinking);
        break;
      case "output_audio_buffer.started":
        setMood(MOOD.talking);
        break;
      case "output_audio_buffer.stopped":
        setMood(MOOD.idle);
        break;
      case "response.done":
        if (ev.response?.status === "failed") vmi.trigger("error")?.trigger();
        break;
    }
  });
}
Obtenha vmi a partir de rive.viewModelInstance depois de carregar o arquivo com autoBind: true. No React, chame isso de dentro de um effect assim que o data channel e a instância do Rive existirem, e mantenha o avatar em um componente "use client".
Escolha idle ou listening como estado de repouso entre os turnos. Um agente de voz com microfone sempre aberto costuma parecer mais natural repousando em listening, já que ele está, de fato, ouvindo.
Por que não existe evento output_audio_buffer via WebSocket?
Via WebSocket, o player de áudio é o seu código. O servidor envia os deltas assim que os gera e não tem como saber quando seus alto-falantes terminam de tocar, então não há buffer do lado do servidor para reportar. Você precisa acompanhar o fim da reprodução por conta própria.
Se você agenda os blocos decodificados em um AudioContext da Web Audio, mantenha um "playhead" atualizado com o momento em que o áudio na fila termina:
const ctx = new AudioContext();
let playhead = 0;        // AudioContext time when queued audio ends
let responseDone = false;
let talking = false;

function playChunk(buffer: AudioBuffer) {
  if (!talking) {
    talking = true;
    setMood(MOOD.talking);
  }
  const src = ctx.createBufferSource();
  src.buffer = buffer;
  src.connect(ctx.destination);
  playhead = Math.max(playhead, ctx.currentTime);
  src.start(playhead);
  playhead += buffer.duration;
  src.onended = () => {
    if (responseDone && ctx.currentTime >= playhead - 0.01) {
      talking = false;
      setMood(MOOD.idle);
    }
  };
}

ws.addEventListener("message", (e) => {
  const ev = JSON.parse(e.data);
  if (ev.type === "response.created") responseDone = false;
  if (ev.type === "response.output_audio.delta") playChunk(decode(ev.delta));
  if (ev.type === "response.output_audio.done") responseDone = true;
});
decode() representa a sua conversão do delta em Base64 para um AudioBuffer; o formato exato depende das configurações de áudio de saída da sua sessão. Os navegadores também exigem um gesto do usuário antes que um AudioContext possa iniciar, então crie ou retome o contexto no botão que inicia a sessão (guia de autoplay da MDN).
Como lidar com barge-in (quando o usuário interrompe)?
Barge-in é quando o usuário começa a falar por cima do agente. O avatar deve ir imediatamente para listening, porque é isso que uma pessoa faria.
- WebRTC: no modo VAD, o servidor emite
output_audio_buffer.clearedquando o usuário interrompe, junto cominput_audio_buffer.speech_started. Qualquer um dos dois leva o avatar para listening; o código acima trata ambos. - WebSocket: em
speech_started, pare todos osAudioBufferSourceNodena fila, zere o playhead e defina listening. Se você não parar a reprodução, o avatar mostra listening enquanto a resposta antiga continua tocando, o que confunde.
A resposta interrompida ainda termina com response.done. A OpenAI diz que esse evento é sempre emitido, qualquer que seja o estado final, e que os clientes devem verificar o status, que pode ser completed, cancelled, failed ou incomplete (eventos do servidor da OpenAI). Só failed merece uma reação de erro. Uma resposta cancelled depois de um barge-in é o sistema funcionando como previsto; não faça o avatar parecer triste por isso.
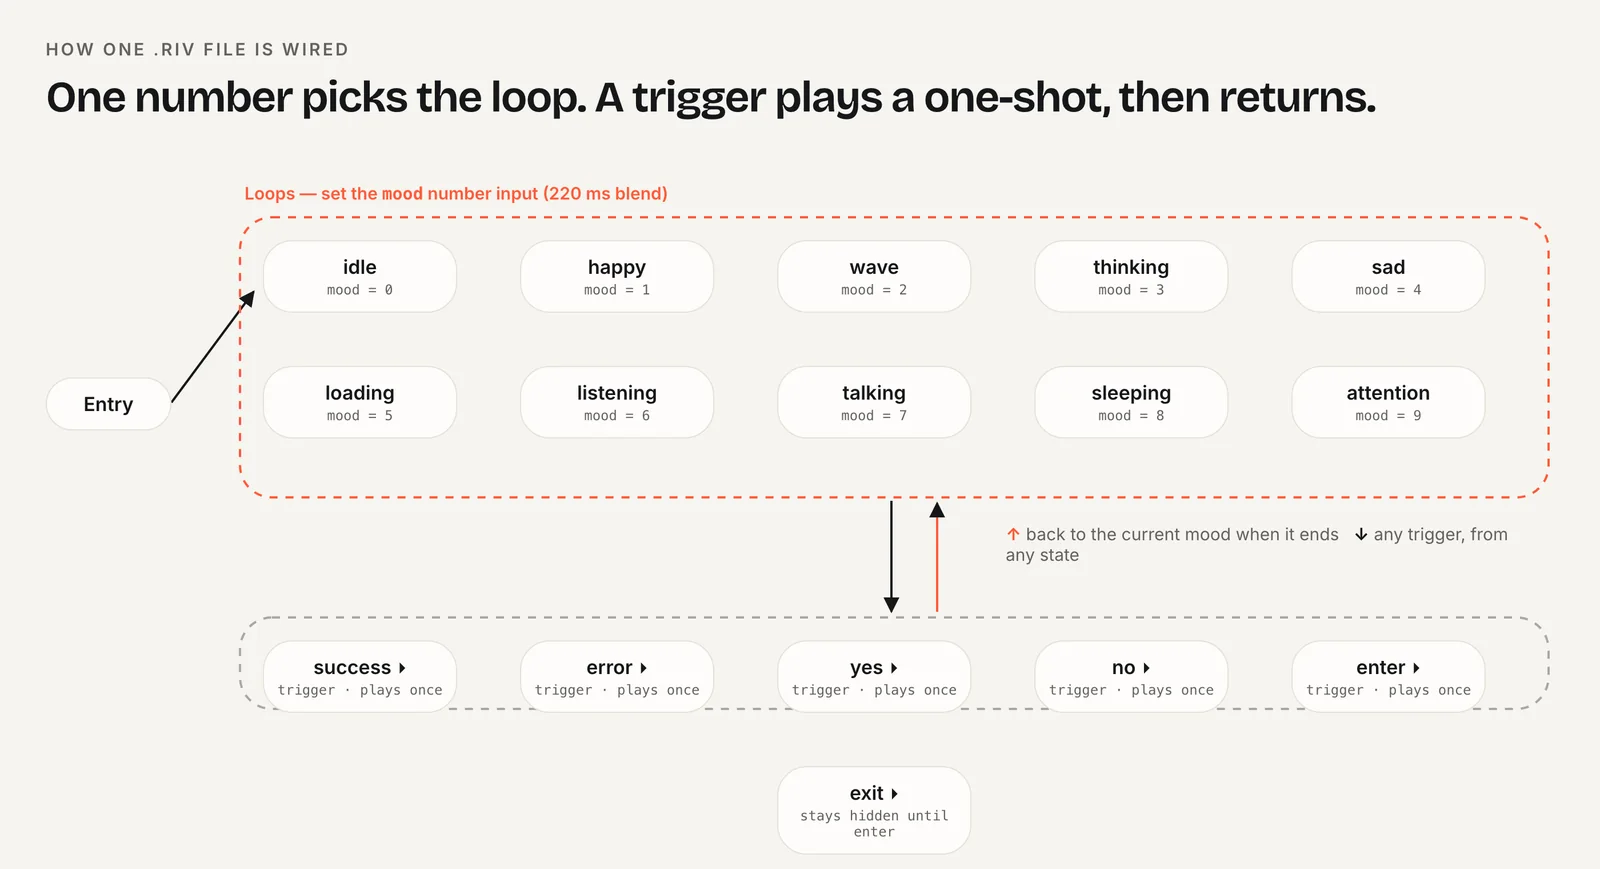
Como todas as fases deste guia mudam o mood em vez de disparar um trigger, as interrupções saem baratas: definir um novo mood simplesmente troca o loop. É melhor reservar as reações únicas para resultados claros, como uma chamada de ferramenta concluída.
Por que o output_audio_buffer.stopped chega atrasado ou não chega?
Desenvolvedores no fórum da comunidade da OpenAI relataram output_audio_buffer.stopped chegando com longos atrasos e deixando de ser enviado enquanto uma chamada de função está pendente, até que o resultado da ferramenta seja retornado (tópico na comunidade da OpenAI). São relatos da comunidade, não comportamento documentado, mas são comuns o bastante para você se preparar.
Defesas práticas:
- Fique em thinking durante as chamadas de ferramenta. Quando o modelo chama uma função, o agente está trabalhando, não falando. Mude para thinking (ou loading) até enviar o resultado e um novo áudio começar.
- Adicione um timer de fallback. Depois de
response.done, sestoppednão chegar alguns segundos após o fim previsto do áudio, volte ao seu mood de repouso mesmo assim. - Use o próprio áudio como segundo sinal. Conecte a faixa de áudio remota a um
AnalyserNodee trate algumas centenas de milissegundos de silêncio como o fim da fala. Lip-sync vs amplitude mostra o código de RMS e histerese.
O sinal que disparar primeiro vence, e todos os seguintes não fazem nada, porque o mood já está definido.
Como mostrar um estado thinking entre os turnos?
O thinking cobre o intervalo entre o fim da fala do usuário e o primeiro áudio do modelo. Neste mapeamento, ele começa em speech_stopped e termina em output_audio_buffer.started (WebRTC) ou no primeiro response.output_audio.delta (WebSocket). Você também pode defini-lo em response.created quando você mesmo inicia as respostas, por exemplo depois de enviar uma entrada de texto.
O layout de dez humores usado neste guia corresponde um a um aos turnos do Realtime: listening (6) enquanto o usuário fala, thinking (3) enquanto o modelo trabalha, talking (7) enquanto o áudio toca. O Charmotion cria esse layout a partir do seu próprio personagem ou logo em poucos minutos, com um view model Character que guarda o número mood e os triggers success/error, além de versões em MP4 e vídeo transparente para marketing. O conjunto completo, com .riv e vídeo transparente, vem com todos os planos pagos. O estado talking é um loop, não sincronização labial, o que combina com um agente cujas falas também aparecem em uma transcrição.
Para qualquer personagem, mantenha o thinking discreto. Ele pode tocar por uma fração de segundo na maioria dos turnos e por vários segundos quando uma chamada de ferramenta é executada, então um loop suave que funcione bem nas duas durações é melhor do que um dramático. Combine esperas longas com um status curto em texto, como "Verificando sua agenda."
Perguntas frequentes
Qual evento da Realtime indica que o usuário começou a falar?
input_audio_buffer.speech_started, enviado no modo server VAD quando o servidor detecta fala no buffer de entrada. A OpenAI sugere usá-lo para interromper a reprodução ou dar feedback visual, então ele é o gatilho natural para um estado listening. Em seguida vem input_audio_buffer.speech_stopped, quando o usuário para de falar.
response.audio.delta ainda é o nome certo do evento?
Não. A referência atual da Realtime o chama de response.output_audio.delta, seguido de response.output_audio.done. response.audio.delta vem de exemplos da época da versão beta. Se o seu listener copiado de um tutorial antigo nunca dispara, renomeie-o. O primeiro delta de uma resposta é um bom sinal para iniciar o estado talking via WebSocket.
O output_audio_buffer.stopped funciona via WebSocket?
Não. A OpenAI documenta output_audio_buffer.started, stopped e cleared como exclusivos de WebRTC/SIP. Via WebSocket, é você quem reproduz o áudio, então acompanhe quando a sua própria fila de reprodução termina e volte o avatar para idle ou listening nesse momento, não em response.output_audio.done.
Uma resposta cancelada deve mostrar uma animação de erro?
Não. Depois de uma interrupção (barge-in), response.done chega com status cancelled, o que é esperado. Só um status failed indica um problema real que justifica uma reação de erro. Mude o avatar para listening na interrupção, pare qualquer reprodução na fila e deixe as respostas canceladas passarem em silêncio, sem reação.
Respostas rápidas deste guia
Fontes
- Realtime API server events, OpenAI
- output_audio_buffer.stopped not sent when tool call is pending, OpenAI Developer Community
- Web runtime: Data binding, Rive
- Autoplay guide for media and Web Audio APIs, MDN Web Docs
- AnalyserNode, MDN Web Docs