वॉइस एजेंट अवतार: OpenAI Realtime इवेंट मैपिंग
Charmotion टीम द्वारा · अपडेट:
OpenAI Realtime server events से voice agent avatar चलाएँ: input_audio_buffer.speech_started पर listening, speech_stopped पर thinking, response का पहला audio आने पर talking, और playback खत्म होने पर idle। WebRTC पर output_audio_buffer.started और stopped playback को चिह्नित करते हैं; WebSocket पर अपनी playback queue खुद ट्रैक करें।
मुख्य बातें
input_audio_buffer.speech_startedऔरspeech_stoppedserver VAD से आते हैं और listening और thinking से मैप होते हैं।- मौजूदा audio event का नाम
response.output_audio.deltaहै; पुराने tutorialsresponse.audio.deltaइस्तेमाल करते हैं। output_audio_buffer.started,stoppedऔरclearedको सिर्फ़ WebRTC/SIP के लिए documented बताया गया है।- Barge-in के बाद रद्द हुए response को सामान्य मानें, और देर से आने वाले
stoppedevent के लिए fallback रखें।
पहले से कोई कैरेक्टर या लोगो है? अपने कैरेक्टर को असली ऐप स्क्रीन में देखें: स्प्लैश, ऑनबोर्डिंग, लोडिंग और एम्प्टी स्टेट स्क्रीन। यह फ़्री है, आपके ब्राउज़र में चलता है और कुछ भी अपलोड नहीं होता।
कौन से Realtime events बताते हैं कि यूज़र ने बोलना शुरू किया या बंद किया?
Server voice activity detection (VAD) चालू होने पर, Realtime API audio buffer में speech पहचानते ही input_audio_buffer.speech_started भेजता है। OpenAI के reference के अनुसार client इस event का इस्तेमाल audio playback रोकने या visual feedback देने के लिए कर सकता है, और avatar ठीक इसी काम के लिए है। फिर speech खत्म होने पर यह input_audio_buffer.speech_stopped भेजता है (OpenAI server events)।
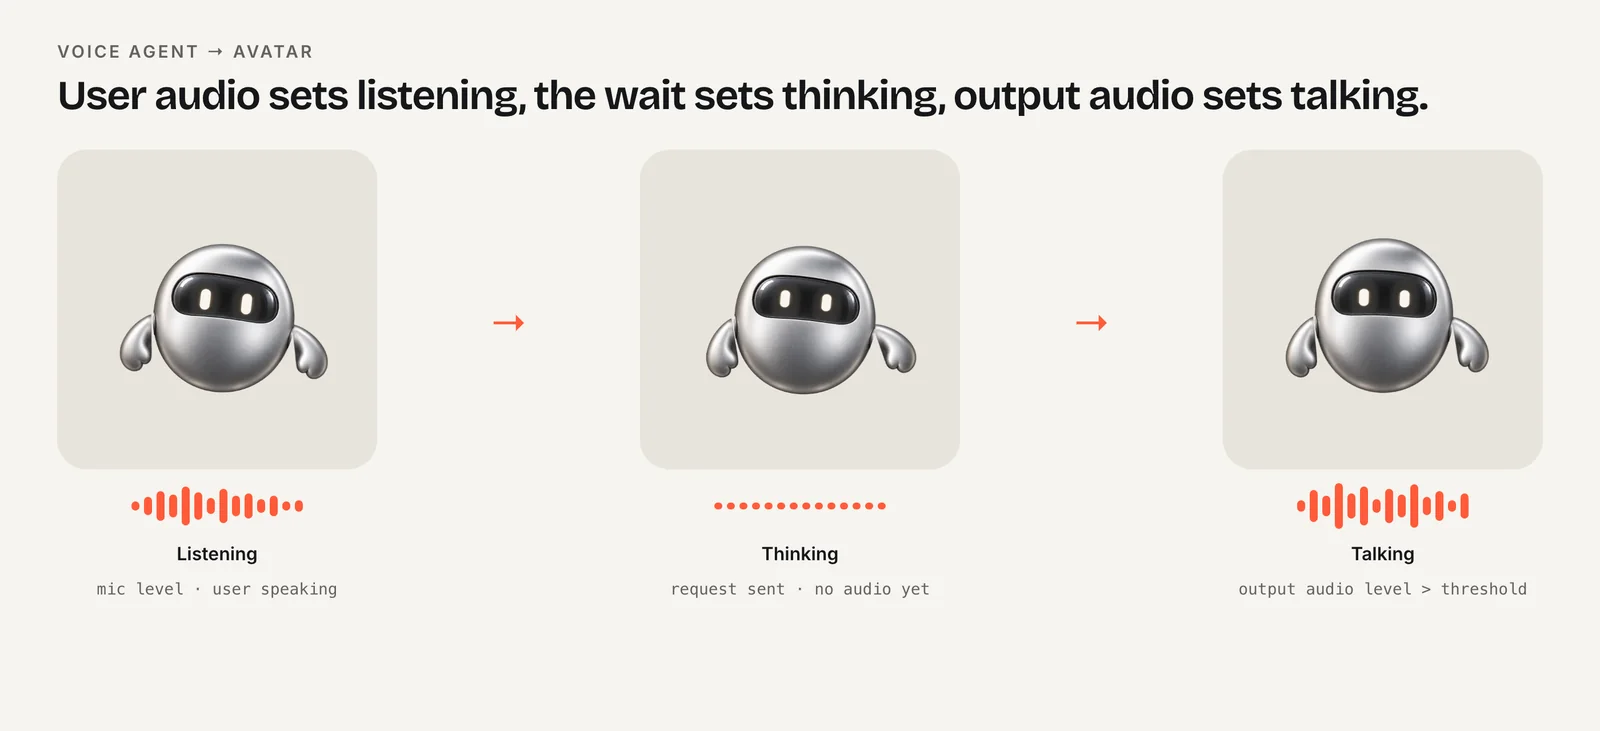
इन्हें इस तरह मैप करें:
speech_started→ listening. तुरंत switch करें। यह "मैं आपको सुन रहा हूँ" वाला पल है, और ज़रा-सी भी देरी से लगता है जैसे agent ध्यान नहीं दे रहा।speech_stopped→ thinking. Model जवाब देने वाला है। यह अंतराल आमतौर पर छोटा होता है, लेकिन दिखाई देता है।
ये इवेंट VAD पर निर्भर हैं। अगर आप VAD बंद करके audio buffer खुद commit करते हैं (push-to-talk), तो आपको पहले से पता होता है कि यूज़र कब बोलना शुरू और बंद करता है, क्योंकि यह काम आपके अपने बटन handlers ही करते हैं। बटन दबाने पर listening और छोड़ने पर thinking सेट करें।
कम्युनिटी थ्रेड्स में बताया गया है कि शोर वाले माहौल में speech_stopped कभी-कभी देर से आता है या आता ही नहीं। avatar को अटकने न दें: अगर आप अभी listening में हैं और response शुरू हो जाए, तो सीधे talking पर जाएँ।
कैसे पता करें कि मॉडल कब बोलना शुरू और बंद करता है?
यहाँ transport मायने रखता है। Realtime API WebRTC पर (ऑडियो media track पर, इवेंट data channel पर) या WebSocket पर (ऑडियो और इवेंट JSON मैसेज के रूप में) चल सकता है।
| चरण | WebRTC | WebSocket | अवतार |
|---|---|---|---|
| यूज़र बोलना शुरू करता है | input_audio_buffer.speech_started | वही | Listening (6) |
| यूज़र बोलना बंद करता है | input_audio_buffer.speech_stopped | वही | Thinking (3) |
| मॉडल का ऑडियो शुरू होता है | output_audio_buffer.started | पहला response.output_audio.delta | Talking (7) |
| मॉडल का ऑडियो खत्म होता है | output_audio_buffer.stopped | आपकी playback queue खाली हो जाती है | Idle (0) या listening (6) |
| यूज़र बीच में बोलता है | output_audio_buffer.cleared | speech_started + अपना playback रोकें | Listening (6) |
| Response फ़ेल हुआ | response.done, status failed | वही | error फ़ायर करें |
OpenAI के डॉक्यूमेंटेशन के अनुसार output_audio_buffer.started तब भेजा जाता है जब सर्वर क्लाइंट को ऑडियो स्ट्रीम करना शुरू करता है, और stopped तब, जब सर्वर पर output buffer पूरी तरह खाली हो जाता है, यानी response.done के बाद। दोनों पर सिर्फ़ WebRTC/SIP का लेबल है। WebSocket पर ऑडियो response.output_audio.delta में Base64 chunks के रूप में आता है, जिसके बाद response.output_audio.done आता है (OpenAI server events)।
ध्यान दें कि response.output_audio.done का मतलब है कि सर्वर ने ऑडियो भेजना पूरा कर लिया, यह नहीं कि यूज़र ने उसे सुन लिया। आपके player की queue में पड़े chunks उसके बाद भी कई सेकंड तक चल सकते हैं।
WebRTC पर इवेंट को Rive avatar से कैसे जोड़ें?
WebRTC पर सर्वर इवेंट उस data channel पर JSON strings के रूप में आते हैं जो आपने इवेंट के लिए बनाया है। हर मैसेज को parse करें और type पर switch करें। avatar को Rive web runtime के data binding API से अपडेट किया जाता है: लूप के लिए number("mood").value और वन-शॉट के लिए trigger("error").trigger() (Rive web data binding)।
import type { ViewModelInstance } from "@rive-app/webgl2";

const MOOD = { idle: 0, thinking: 3, listening: 6, talking: 7 } as const;

export function bindAvatarToRealtime(dc: RTCDataChannel, vmi: ViewModelInstance) {
  const mood = vmi.number("mood");
  const setMood = (m: number) => {
    if (mood) mood.value = m;
  };

  dc.addEventListener("message", (e) => {
    const ev = JSON.parse(e.data);
    switch (ev.type) {
      case "input_audio_buffer.speech_started":
      case "output_audio_buffer.cleared":
        setMood(MOOD.listening);
        break;
      case "input_audio_buffer.speech_stopped":
        setMood(MOOD.thinking);
        break;
      case "output_audio_buffer.started":
        setMood(MOOD.talking);
        break;
      case "output_audio_buffer.stopped":
        setMood(MOOD.idle);
        break;
      case "response.done":
        if (ev.response?.status === "failed") vmi.trigger("error")?.trigger();
        break;
    }
  });
}
फ़ाइल को autoBind: true के साथ लोड करने के बाद rive.viewModelInstance से vmi लें। React में इसे एक effect से तब कॉल करें जब data channel और Rive instance दोनों मौजूद हों, और avatar को "use client" component में रखें।
turns के बीच अपनी resting स्टेट के लिए idle या listening चुनें। हमेशा खुले माइक्रोफ़ोन वाला voice agent अक्सर listening पर ज़्यादा स्वाभाविक लगता है, क्योंकि वह असल में सुन ही रहा होता है।
WebSocket पर output_audio_buffer इवेंट क्यों नहीं है?
WebSocket पर audio player आपका code ही है। सर्वर deltas उतनी ही तेज़ी से भेजता है जितनी तेज़ी से उन्हें बनाता है, और उसके पास यह जानने का कोई तरीका नहीं कि आपके speakers कब बजना बंद करते हैं, इसलिए रिपोर्ट करने के लिए कोई server-side buffer नहीं है। playback का अंत आपको खुद ट्रैक करना होगा।
अगर आप decoded chunks को Web Audio AudioContext पर schedule करते हैं, तो एक चलता हुआ "playhead" रखें जो बताए कि queue में रखा ऑडियो कब खत्म होगा:
const ctx = new AudioContext();
let playhead = 0;        // AudioContext time when queued audio ends
let responseDone = false;
let talking = false;

function playChunk(buffer: AudioBuffer) {
  if (!talking) {
    talking = true;
    setMood(MOOD.talking);
  }
  const src = ctx.createBufferSource();
  src.buffer = buffer;
  src.connect(ctx.destination);
  playhead = Math.max(playhead, ctx.currentTime);
  src.start(playhead);
  playhead += buffer.duration;
  src.onended = () => {
    if (responseDone && ctx.currentTime >= playhead - 0.01) {
      talking = false;
      setMood(MOOD.idle);
    }
  };
}

ws.addEventListener("message", (e) => {
  const ev = JSON.parse(e.data);
  if (ev.type === "response.created") responseDone = false;
  if (ev.type === "response.output_audio.delta") playChunk(decode(ev.delta));
  if (ev.type === "response.output_audio.done") responseDone = true;
});
decode() का मतलब है Base64 delta को AudioBuffer में बदलने वाला आपका conversion; सटीक format आपके session की output audio settings पर निर्भर करता है। ब्राउज़र किसी AudioContext को शुरू करने से पहले user gesture भी माँगते हैं, इसलिए इसे उसी बटन से बनाएँ या resume करें जो session शुरू करता है (MDN autoplay guide)।
barge-in (यूज़र का बीच में बोलना) को कैसे हैंडल करें?
Barge-in तब होता है जब यूज़र agent के बोलते समय ही बोलना शुरू कर देता है। avatar को तुरंत listening पर आ जाना चाहिए, क्योंकि कोई इंसान भी यही करता।
- WebRTC: VAD मोड में, जब यूज़र बीच में बोलता है तो सर्वर
output_audio_buffer.clearedभेजता है, और साथ मेंinput_audio_buffer.speech_startedभी। इनमें से कोई भी avatar को listening पर ले जाता है; ऊपर का code दोनों को हैंडल करता है। - WebSocket:
speech_startedआने पर queue में रखे हरAudioBufferSourceNodeको रोकें, अपना playhead reset करें और listening सेट करें। अगर आप playback नहीं रोकते, तो avatar listening दिखाएगा जबकि पुराना जवाब चलता रहेगा, और यह उलझन पैदा करता है।
बीच में रोका गया response भी response.done के साथ ही खत्म होता है। OpenAI के अनुसार यह इवेंट हमेशा भेजा जाता है, final state चाहे जो भी हो, और clients को इसका status जाँचना चाहिए, जो completed, cancelled, failed या incomplete हो सकता है (OpenAI server events)। सिर्फ़ failed पर error रिएक्शन दिखाना सही है। barge-in के बाद cancelled response का मतलब है कि सिस्टम वैसे ही काम कर रहा है जैसा उसे डिज़ाइन किया गया है; इस पर avatar को उदास न दिखाएँ।
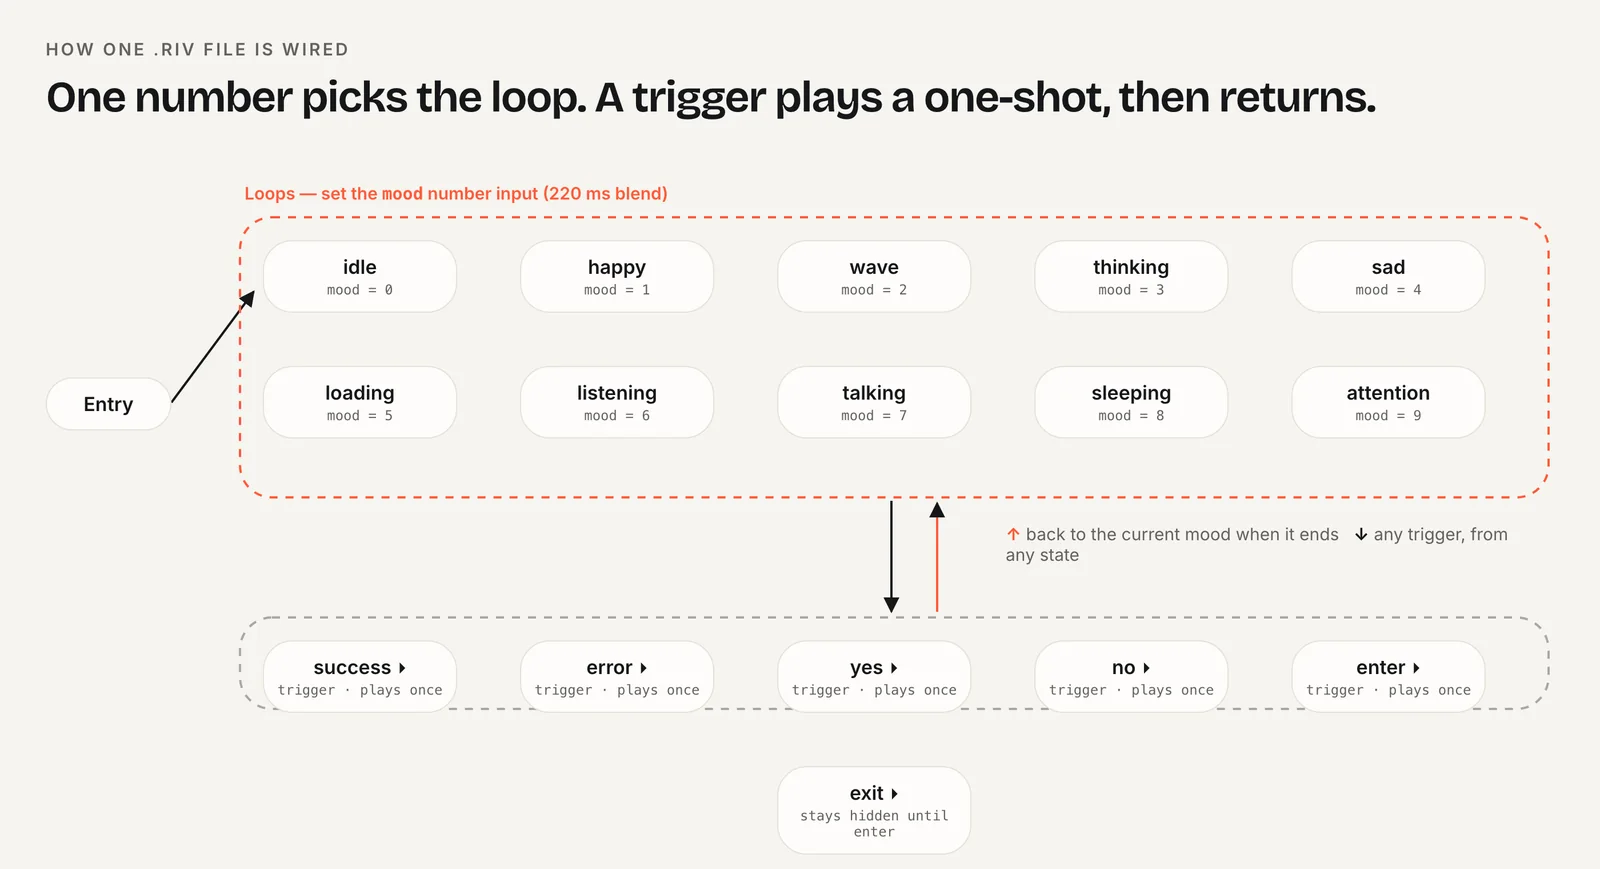
इस गाइड में हर चरण ट्रिगर फ़ायर करने के बजाय मूड बदलता है, इसलिए interruptions को संभालना आसान रहता है: नया मूड सेट करने से बस लूप बदल जाता है। वन-शॉट को साफ़ नतीजों के लिए बचाकर रखना बेहतर है, जैसे कोई पूरा हुआ tool call।
output_audio_buffer.stopped देर से क्यों आता है या आता ही क्यों नहीं?
OpenAI community forum पर डेवलपर्स ने बताया है कि output_audio_buffer.stopped काफ़ी देर से आता है, और जब कोई function call pending हो तो tool result लौटाए जाने तक भेजा ही नहीं जाता (OpenAI community thread)। ये documented behavior नहीं, बल्कि कम्युनिटी की रिपोर्ट हैं, लेकिन इतनी आम हैं कि इन्हें ध्यान में रखकर डिज़ाइन करना चाहिए।
व्यावहारिक बचाव:
- tool calls के दौरान thinking में रहें। जब मॉडल कोई function कॉल करता है, तो agent काम कर रहा होता है, बोल नहीं रहा। जब तक आप result नहीं भेजते और नया ऑडियो शुरू नहीं होता, thinking (या loading) पर रहें।
- एक fallback timer जोड़ें।
response.doneके बाद, अगर अपेक्षित ऑडियो के कुछ सेकंड के भीतरstoppedनहीं आता, तो भी अपने resting mood पर लौट जाएँ। - ऑडियो को ही दूसरे signal की तरह इस्तेमाल करें। remote audio track को एक
AnalyserNodeसे जोड़ें और कई सौ मिलीसेकंड की खामोशी को बोलने का अंत मानें। Lip-sync बनाम amplitude में RMS और hysteresis का code दिया गया है।
जो signal पहले आता है वही मान्य होता है, और उसके बाद आने वाला हर signal no-op बन जाता है, क्योंकि मूड पहले से सेट है।
turns के बीच thinking स्टेट कैसे दिखाएँ?
Thinking यूज़र के बोलना खत्म करने और मॉडल के पहले ऑडियो के बीच के अंतराल को कवर करता है। इस mapping में यह speech_stopped पर शुरू होता है और output_audio_buffer.started (WebRTC) या पहले response.output_audio.delta (WebSocket) पर खत्म होता है। जब आप responses खुद शुरू करते हैं, जैसे text input भेजने के बाद, तो इसे response.created पर भी सेट कर सकते हैं।
इस गाइड में इस्तेमाल किया गया दस-मूड लेआउट Realtime के हर टर्न से सीधे मेल खाता है: यूज़र के बोलते समय listening (6), मॉडल के काम करते समय thinking (3), ऑडियो चलते समय talking (7)। Charmotion यह लेआउट आपके अपने कैरेक्टर या लोगो से बनाता है, कुछ ही मिनटों में, mood नंबर और success/error ट्रिगर वाले Character व्यू मॉडल के साथ, साथ में मार्केटिंग के लिए MP4 और ट्रांसपेरेंट वीडियो वर्ज़न। पूरा सेट, .riv और ट्रांसपेरेंट वीडियो समेत, हर पेड प्लान के साथ मिलता है। इसकी talking स्टेट लिप-सिंक के बजाय एक लूप है, जो ऐसे एजेंट के लिए सही है जिसके शब्द ट्रांसक्रिप्ट के रूप में भी दिखते हैं।
किसी भी कैरेक्टर के लिए thinking को हल्का रखें। ज़्यादातर turns पर यह एक सेकंड से भी कम चल सकता है और tool call चलने पर कई सेकंड तक, इसलिए दोनों लंबाई पर अच्छा दिखने वाला हल्का लूप किसी नाटकीय लूप से बेहतर है। लंबे इंतज़ार के साथ एक छोटा text status दिखाएँ, जैसे "आपका कैलेंडर देखा जा रहा है।"
अक्सर पूछे जाने वाले सवाल
कौन-सा Realtime इवेंट बताता है कि यूज़र ने बोलना शुरू किया?
input_audio_buffer.speech_started, जो server VAD मोड में तब भेजा जाता है जब सर्वर input buffer में आवाज़ पहचानता है। OpenAI इसे playback रोकने या visual feedback देने के लिए इस्तेमाल करने का सुझाव देता है, इसलिए listening स्टेट के लिए यह स्वाभाविक ट्रिगर है। यूज़र के रुकने पर input_audio_buffer.speech_stopped आता है।
क्या response.audio.delta अब भी सही इवेंट नाम है?
नहीं। मौजूदा Realtime reference में इसका नाम response.output_audio.delta है, जिसके बाद response.output_audio.done आता है। response.audio.delta beta दौर के examples से आया है। अगर किसी पुराने tutorial से कॉपी किया गया आपका listener कभी फ़ायर नहीं होता, तो उसका नाम बदल दें। WebSocket पर talking स्टेट शुरू करने के लिए किसी response का पहला delta अच्छा signal है।
क्या output_audio_buffer.stopped WebSocket पर काम करता है?
नहीं। OpenAI के डॉक्यूमेंटेशन में output_audio_buffer.started, stopped और cleared सिर्फ़ WebRTC/SIP के लिए बताए गए हैं। WebSocket पर ऑडियो आप खुद प्ले करते हैं, इसलिए अपनी playback queue खत्म होने का समय खुद ट्रैक करें और उसी पल avatar को वापस idle या listening पर ले जाएँ, response.output_audio.done पर नहीं।
क्या रद्द हुए response पर error एनिमेशन दिखाना चाहिए?
नहीं। barge-in के बाद response.done का status cancelled आता है, और यह अपेक्षित है। सिर्फ़ failed status ही असली समस्या बताता है, जिस पर error रिएक्शन दिखाना ठीक है। रुकावट होते ही avatar को listening पर ले जाएँ, queue में पड़ा playback रोक दें, और cancelled responses को बिना किसी रिएक्शन के चुपचाप जाने दें।
इस गाइड से झटपट जवाब
स्रोत
- Realtime API server events, OpenAI
- output_audio_buffer.stopped not sent when tool call is pending, OpenAI Developer Community
- Web runtime: Data binding, Rive
- Autoplay guide for media and Web Audio APIs, MDN Web Docs
- AnalyserNode, MDN Web Docs