Anime um assistente de IA: listening e talking
Por equipe Charmotion · Atualizado em
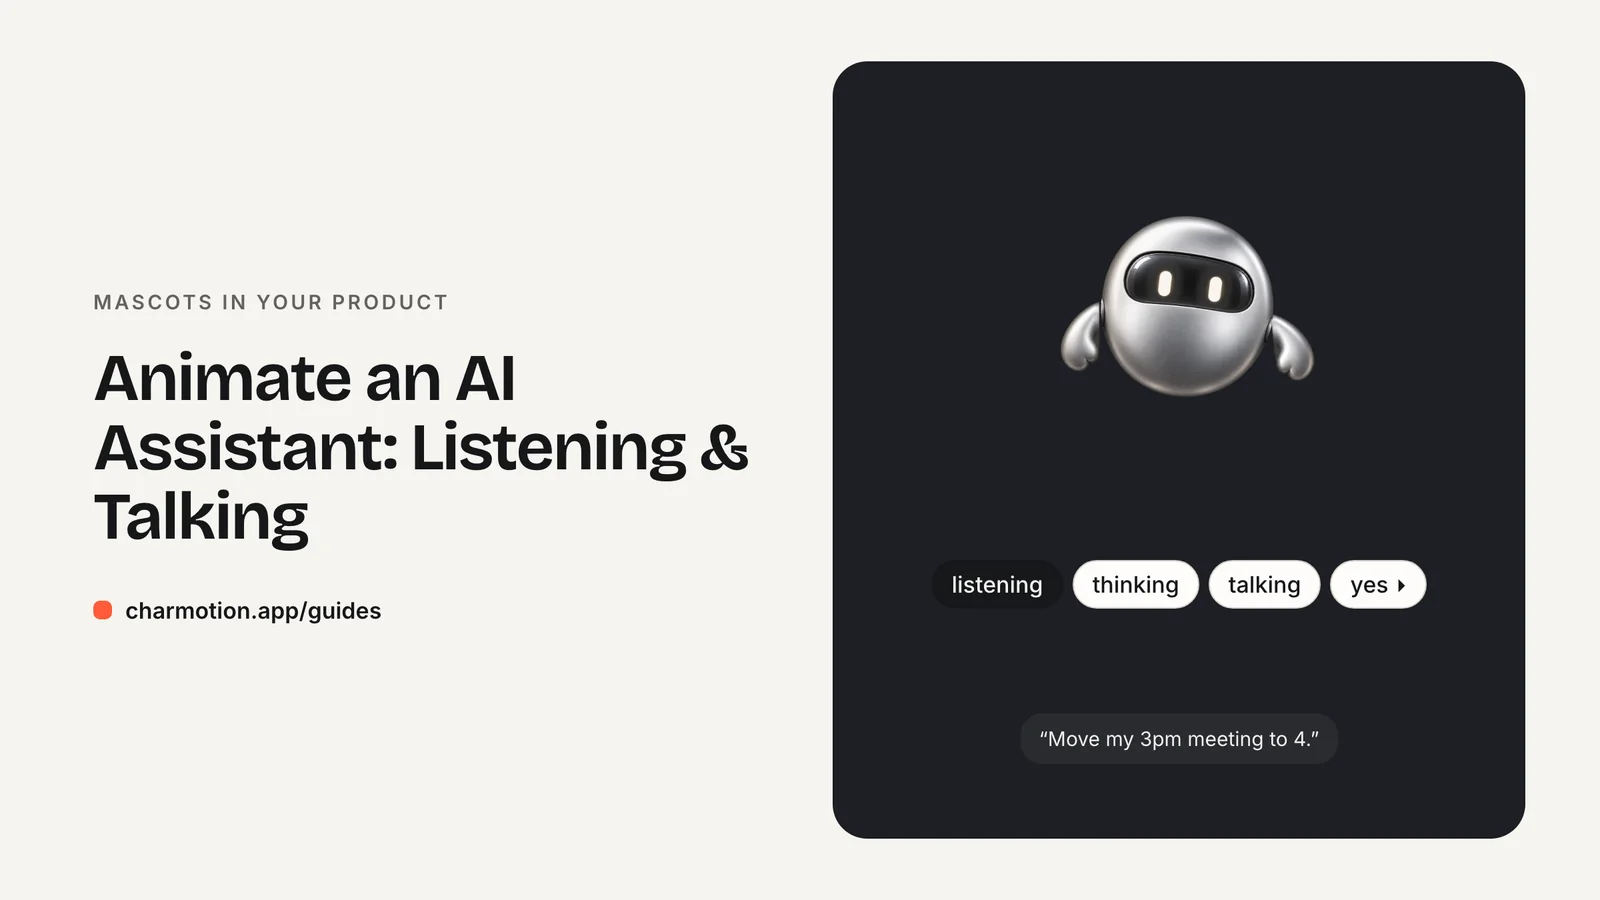
Um avatar de assistente de IA precisa de cinco estados principais: idle, listening, thinking, talking e uma reação de confirmação. Mude para listening quando o usuário digitar ou falar, para thinking quando a requisição for enviada, para talking quando o primeiro token ou áudio chegar e de volta para idle quando a resposta terminar. Adicione uma reação de error e uma alternativa para movimento reduzido.
Principais pontos
- Controle o avatar a partir de eventos da conversa, não de timers: entrada iniciada, requisição enviada, primeiro token, stream encerrado.
- O thinking deve cobrir apenas o intervalo antes do primeiro token; mude para talking assim que a saída começar.
- Um loop de talking basta para chat de texto. Produtos de voz podem controlar a boca pelo nível do áudio ou por visemas.
- Sempre mostre o status também em texto e ofereça uma alternativa estática quando o movimento reduzido estiver ativado.
Já tem um personagem ou logo? Veja seu personagem em telas reais de app: telas de splash, onboarding, carregamento e estado vazio. É grátis, roda no navegador e não envia nada.
De quais estados um avatar de assistente de IA precisa?
Um assistente tem um ciclo de vida mais claro do que um mascote comum, porque toda conversa segue o mesmo loop: o usuário fala, o modelo processa, o modelo responde. O avatar espelha esse ciclo.
| Estado | Tipo | Significado para o usuário |
|---|---|---|
| Idle | Loop | Pronto, aguardando entrada |
| Listening | Loop | "Estou ouvindo" enquanto o usuário fala ou digita |
| Thinking | Loop | Requisição enviada, ainda sem resposta |
| Talking | Loop | Resposta sendo transmitida ou áudio tocando |
| Confirmação / sucesso | Reação única | Uma ação foi concluída, como uma reserva ou uma nota salva |
| Error | Reação única | A requisição falhou ou foi recusada |
| Dormindo | Loop | Sessão inativa ou assistente silenciado |
Esse conjunto está próximo do que virou uma convenção. O AI Elements da Vercel, por exemplo, traz um componente Persona feito com Rive, com os estados idle, listening, thinking, speaking e asleep (AI Elements). Se você criar seu próprio avatar, usar esses mesmos nomes facilita a troca.
Como criar o design de um avatar de assistente de IA?
Um avatar de assistente costuma ser pequeno: um selo de 32 a 64 px ao lado das mensagens, ou um personagem maior em uma tela de voz. Projete primeiro para o tamanho pequeno.
- Faça do rosto o foco. Listening, thinking e talking são percebidos quase só pelos olhos e pela boca. Um rosto grande e simples funciona melhor do que um corpo detalhado.
- Dê espaço para a boca se mexer. O talking precisa, no mínimo, de uma forma aberta e uma fechada. Se a boca for só um tracinho, o talking ficará invisível no tamanho de selo.
- Use uma pose diferente para cada estado. No listening, o personagem pode se inclinar para a frente ou inclinar a cabeça; no thinking, pode olhar para cima ou para o lado. O usuário deve distinguir os estados num relance, mesmo sem cor.
- Evite uma aparência humana, a menos que você tenha orçamento para torná-la convincente. Um personagem abstrato e simpático ou uma forma suave deixa claro que o usuário está conversando com um software.
- Mantenha a animação tranquila. O avatar fica ao lado de um texto que o usuário está tentando ler. Movimentos suaves funcionam; pulos, não.
Um personagem de frente, com olhos, boca e partes do corpo separados, é o mais fácil de animar em todos esses estados. Veja como criar um mascote animado para app para o checklist completo de design.
Como associar listening, thinking e talking aos eventos de chat e voz?
Conecte o avatar a eventos que seu stack de chat ou voz já emite. Um mapeamento típico:
| Evento | Estado do avatar |
|---|---|
| Campo em foco e o usuário começa a digitar, ou o microfone é aberto | Listening |
| Mensagem enviada ou fim da fala detectado | Thinking |
| Primeiro token transmitido ou primeiro trecho de áudio | Talking |
| Stream concluído ou áudio encerrado | Idle |
| Chamada de ferramenta concluída (reserva, salvar, enviar) | Reação única de success, depois idle |
| Erro de rede, limite de requisições ou recusa | Reação única de error, depois idle |
| Sem atividade por um tempo, ou sessão encerrada | Dormindo |
Mantenha essa lógica em um só lugar, por exemplo um reducer que recebe o status do chat e retorna o estado do avatar. Não espalhe chamadas de animação pelos componentes da sua interface.
Dois casos extremos aparecem logo. Se o usuário interromper enquanto o assistente está falando, volte direto para listening. Se uma resposta incluir várias chamadas de ferramenta, fique em thinking entre elas em vez de alternar entre thinking e talking.
Como lidar com a latência entre thinking e talking?
O estado thinking existe para cobrir o intervalo entre o envio da requisição e o aparecimento da resposta. A forma como você trata esse intervalo define o quão rápido o assistente parece.
Os limites de tempo de resposta de Nielsen são uma boa referência: cerca de 0,1 s parece instantâneo, cerca de 1 s mantém o fluxo de raciocínio do usuário e cerca de 10 s é o limite para manter a atenção (NN/g). Aplique-os ao avatar:
- Mude para listening instantaneamente quando o microfone abrir ou a digitação começar. Esse feedback deve parecer imediato.
- Entre em thinking logo após o envio, mas faça uma transição suave para que um primeiro token rápido não cause uma oscilação brusca.
- Mude para talking no primeiro token, e não quando a resposta completa chegar. Texto em streaming junto com um avatar falando faz a espera parecer menor.
- Depois de uns 10 segundos, adicione um status em texto, como "Pesquisando seus arquivos", para o usuário saber o que está acontecendo.
Evite um loop de talking que continua depois que o texto terminou de ser transmitido. Encerre-o no evento de conclusão do stream, não com um timer.
Como controlar o talking a partir do áudio?
Existem três níveis de fidelidade. Escolha o mais simples que atenda ao seu produto.
- Um loop de talking genérico. A boca se move em um ciclo repetido enquanto a resposta é transmitida. Isso basta para chat de texto, em que o usuário lê a resposta e só dá uma olhada no avatar.
- Boca controlada pela amplitude. Para voz, leia o nível do áudio de saída e envie esse valor para um número na animação, assim a boca abre mais nas sílabas mais altas e fecha nas pausas. No Rive, isso é um input numérico ou uma propriedade numérica do view model atualizada a cada frame.
- Visemas. Associe os fonemas do seu mecanismo de fala a formatos de boca. É a opção mais convincente e a que dá mais trabalho. O Duolingo usa state machines do Rive para sincronizar os lábios dos seus personagens dessa forma em todos os cursos (blog do Duolingo).
Seja qual for o nível escolhido, suavize a entrada. Níveis de áudio brutos oscilam muito e fazem a boca tremer. Uma média móvel curta ou um pouco de easing no valor fica muito mais natural.
Devo usar Rive ou vídeo para um avatar de IA?
Use um runtime interativo como o Rive para o avatar dentro do produto. Um assistente muda de estado o tempo todo e de forma imprevisível, muitas vezes várias vezes por segundo em torno de uma resposta curta. Uma state machine consegue fazer a transição de listening para thinking e para talking a partir de qualquer ponto de um loop. Com vídeo, cada estado é um clipe separado, e pular de um clipe para outro no meio do loop gera cortes visíveis, a menos que você adicione crossfades e um timing cuidadoso.
Arquivos interativos também permitem controlar valores continuamente, como a abertura da boca a partir do áudio, algo que o vídeo não consegue fazer.
O vídeo ainda tem seu papel:
- Páginas de marketing e prévias nas lojas de apps mostrando o assistente em ação.
- Contextos estáticos, como e-mails e artigos de ajuda.
- Um widget web simples com um único estado em loop. Para ter transparência, entregue WebM VP9 com alfa e MOV HEVC com alfa, porque o Safari descarta o canal alfa do WebM (Jake Archibald).
O Charmotion inclui os estados de assistente no conjunto padrão: listening (mood 6) e talking (mood 7) são loops, thinking e sleeping também são loops, e success, error, yes e no são triggers de reação única, tudo em um único arquivo Rive, junto com exportações em MP4 e vídeo transparente em todos os planos pagos.
Como manter um avatar de assistente acessível?
O avatar é uma decoração sobre a conversa. Tudo o que ele comunica também precisa estar disponível sem ele.
- Mostre o status em texto. "Ouvindo", "Pensando" ou um indicador de digitação ao lado do campo de entrada informa o que está acontecendo a quem usa leitor de tela e a quem não está olhando para o avatar.
- Respeite o movimento reduzido. Verifique
prefers-reduced-motionna web (MDN) eaccessibilityReduceMotionno SwiftUI. Troque os loops por poses estáticas para cada estado ou por uma mudança sutil de opacidade. - Permita pausar. Um loop idle que roda ao lado do chat por minutos se enquadra no critério de sucesso 2.2.2 da WCAG 2.2, que exige uma forma de pausar, parar ou ocultar movimentos que começam sozinhos e duram mais de cinco segundos (W3C). A solução mais simples é o avatar parar em uma pose estática quando estiver em idle.
- Deixe o usuário desativar. Uma configuração para ocultar o avatar ou mostrar um ícone estático respeita quem acha qualquer movimento ao lado do texto uma distração.
- Oculte-o das tecnologias assistivas. Marque o avatar como decorativo para que os leitores de tela não anunciem cada mudança de estado.
- Evite efeitos piscantes, principalmente no estado de erro.
Perguntas frequentes
Quais estados um avatar de chatbot com IA deve ter?
Um avatar de chatbot com IA deve ter loops de idle, listening, thinking e talking, além das reações únicas success e error. Um estado de sono para sessões inativas também é útil. Isso segue componentes comuns, como o Persona do Vercel AI Elements, que usa idle, listening, thinking, speaking e asleep.
Quando o avatar deve passar de thinking para talking?
Faça a troca no primeiro token transmitido ou no primeiro trecho de áudio, não quando a resposta completa chegar. Assim o assistente parece mais rápido e a animação fica sincronizada com o que o usuário vê. Volte para idle no evento de conclusão do stream.
Preciso de sincronia labial para um assistente de voz?
Não necessariamente. Um loop de talking funciona bem para chat em texto. Para voz, controlar a abertura da boca pelo nível do áudio fica convincente com pouco trabalho. A sincronia labial completa por visemas, que mapeia fonemas para formatos de boca, é a mais realista, mas exige dados de fonemas do seu mecanismo de fala.
Posso usar um arquivo de vídeo para um avatar de IA animado?
Pode, mas é limitado. Cada estado vira um clipe separado, então trocas rápidas entre listening, thinking e talking mostram cortes. Um formato interativo como o Rive troca de estado a partir de qualquer frame e pode ser controlado por valores em tempo real, como o nível do áudio.
Respostas rápidas deste guia
Fontes
- Persona component, Vercel AI Elements
- Response Times: The 3 Important Limits, Nielsen Norman Group
- How Duolingo's characters lip sync (visemes), Duolingo Blog
- prefers-reduced-motion, MDN Web Docs
- Understanding SC 2.2.2: Pause, Stop, Hide, W3C WAI
- Video with alpha transparency on the web, Jake Archibald